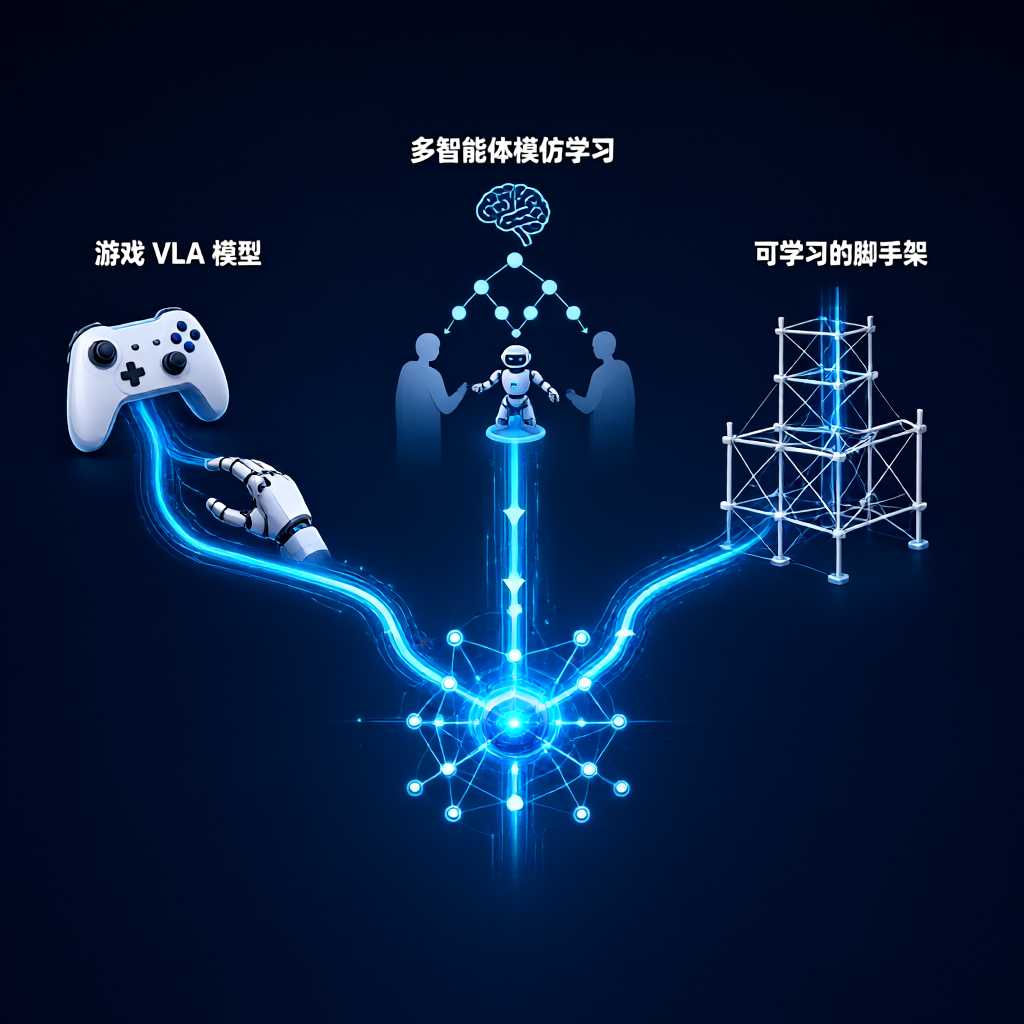
智能体研究最近扎堆往同一个方向使劲:少靠人手工搭流程,让训练本身变得可学习。三篇新工作分别从视觉—语言—动作模型、多智能体模仿学习和"脚手架"三个角度切入。智能体能走多远,取决于它怎么被训练。
Gamer 是一套端到端的通用智能体框架,处理复杂交互环境里的长时程任务。它把感知、记忆管理和多步推理塞进同一个模型,2D 图形界面和 3D 仿真环境都能跑。训练数据是数万小时的键盘鼠标操作,再叠上多轮强化学习。作者说它在 3D 开放世界和 2D 游戏基准上泛化不错,有几款游戏里的表现能和熟练玩家掰手腕。
多智能体这边走的是"先看懂,再自己练"。示范数据能加速单智能体强化学习,搬进多智能体就没那么简单:几个智能体同时学、同时改环境,示范信号很容易失真。Imitation Bootstrapped Multi-Agent Reinforcement Learning 的办法是先用模仿带一段,让智能体从示范里起步,再靠自己的交互接着练。
ModHarness-RL 盯的是另一个常被忽略的东西——harness,包在模型外面那层脚手架,决定模型能看到自己交互的哪一部分、收到什么指引。现在大多是人工写好、固定不动。这篇工作主张把 harness 本身变成可学习、可演化的程序,让它在强化学习过程里跟模型一起迭代。
三条路径都在减少手工设计。Gamer 靠海量交互数据加多轮 RL 直接学策略,模仿学习拿现成示范省掉冷启动,ModHarness-RL 干脆把脚手架也交给优化器。对做智能体产品的人来说,比拼的重点挪到了训练回路怎么设计上,提示词写得巧不巧,反倒次要了。手工调优的余地越来越小,但哪些交给模型学、哪些该固定死,这类判断反而更值钱了。